
Aprovação humana que não é teatro
Em 18 de agosto de 2026, a TechTarget publicou uma reportagem sobre segurança de agentes de IA em que Jess Burn, analista principal da Forrester, faz a pergunta que o mercado vinha evitando: se uma pessoa está revisando centenas de decisões depois do fato, ou aprovando ações que não consegue validar de forma independente, ou sem a expertise para saber o que está olhando, isso é supervisão ou é apenas uma forma de teatro de responsabilidade?
Na mesma reportagem, Will Pearce, da Dreadnode, aponta o caminho de saída: o passo que os defensores precisam dar não é se importar menos, é ficar menos orientado a política e mais orientado a ação.
A crítica é justa. E vale para nós também, porque "você decide, o Myrmex executa" é a nossa frase. Então ela merece resposta, e a resposta não é jurar que temos aprovação humana. Todo mundo tem.
O que torna uma aprovação vazia
Uma aprovação é vazia quando o humano não consegue avaliar o que está aprovando. Isso acontece de três formas, e nenhuma delas se resolve com mais checkbox.
Acontece por volume: trinta pedidos por hora não são trinta decisões, são uma assinatura repetida. Acontece por opacidade: aprovar "executar remediação no endpoint" sem ver o que será executado é autorizar uma caixa fechada. E acontece por descolamento: quando o registro guarda a intenção mas não o comando, o que rodou pode se afastar do que foi aprovado, e ninguém consegue provar a diferença depois.
O resultado comum às três é o mesmo. Fica um registro de quem clicou, não um registro do que aconteceu. Isso passa numa auditoria de processo e falha na hora em que alguém precisa responder o que de fato foi feito no parque.
A pergunta certa tem três partes
Trocamos "existe aprovação humana?" por três perguntas que podem ser verificadas uma a uma:
- O que o humano vê antes de decidir.
- O que acontece durante, depois que ele decide.
- O que fica escrito depois.
É nessas três que dá para separar governança de teatro, porque as três produzem evidência.
Antes: o plano vem antes da ação, e a aprovação sai da conversa
No MYRMEX, o que vai para aprovação não é o pedido, é o plano. Antes de uma mudança de rede no nosso próprio ambiente, a plataforma montou um plano numerado com o alvo e o impacto previsto de cada passo, perguntou se podia criar o rascunho da mudança e registrou a mudança com os passos de implementação e os passos de rollback lado a lado, antes de qualquer execução.
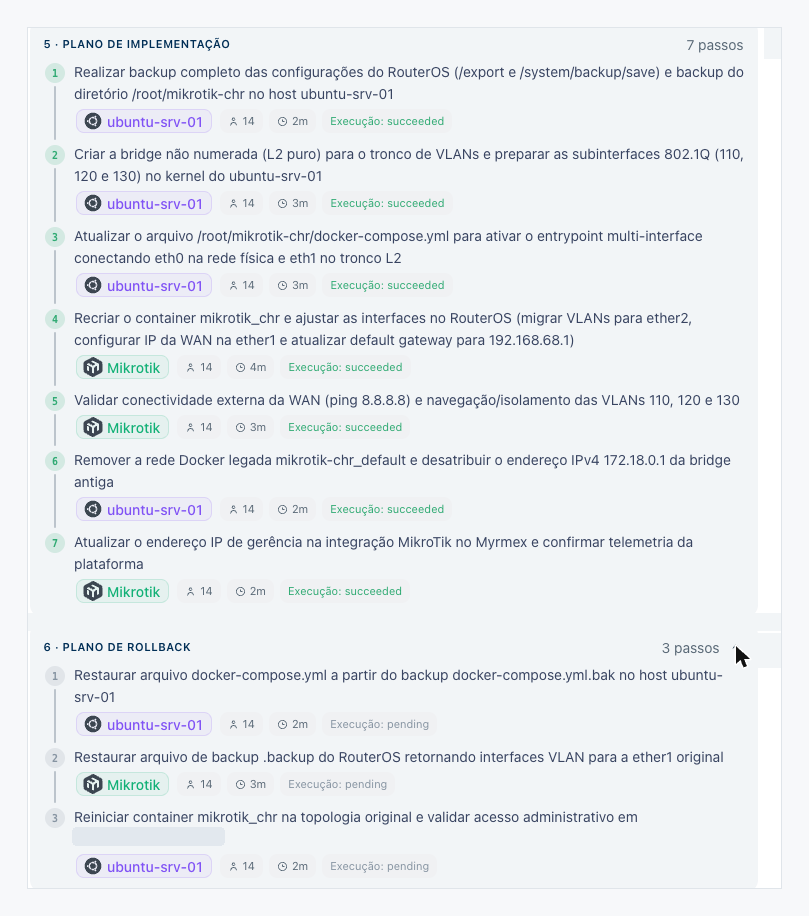
O detalhe que muda a natureza da coisa é onde a aprovação acontece. Ela não acontece na conversa. A mudança fica em rascunho e precisa ser revisada, aprovada e colocada em execução na tela de gestão de mudanças. Isso importa porque o registro da autorização deixa de ser uma mensagem de chat, que é difícil de auditar e fácil de perder de vista, e passa a ser um objeto de governança com estado, janela, ativos impactados e plano de volta.
Em ativo classificado como crítico, a exigência aparece um passo antes. A plataforma declara que o dispositivo está configurado para pedir confirmação antes de qualquer consulta ou edição, e pede autorização explícita mesmo para uma leitura. À primeira vista parece excesso de zelo, e não é: é a única forma de o operador descobrir que aquele ativo é crítico no momento em que isso importa, e não no relatório do mês seguinte.
Durante: verificar em vez de presumir
A execução no MYRMEX segue uma regra que chamamos de Ground Truth Only: nunca simular saída, nunca presumir sucesso. O agente executa e lê a resposta real do sistema operacional ou da API do fornecedor, e é essa resposta que vira status.
A consequência aparece quando algo falha. Numa execução de mudança no nosso próprio ambiente, um passo travou porque a sessão com o equipamento expirou. O produto não completou a tabela com o que era provável. Ele escreveu que os comandos de leitura em tempo real não foram coletados naquela tentativa, que nenhuma tabela ou valor presumido seria apresentado, nomeou as chamadas que falharam e ofereceu duas saídas, uma delas o rollback já registrado na mudança.
O mesmo padrão aparece em auditoria. Quando parte dos controles de uma auditoria de conformidade não pôde ser avaliada porque uma API não estava alcançável, o resultado disse isso em texto claro e manteve postura conservadora, em vez de exibir um valor qualquer. Declarar o que não foi possível determinar é o que separa um laudo de um relatório gerado. E é o oposto do padrão que mais estraga confiança em automação, que é a origem falhar e a tela mostrar um número.
Uma aprovação não vale nada se o que vem depois reporta sucesso que não verificou.
Depois: a cadeia de execução, não só o resultado
O registro que interessa não é "ação X concluída". Na trilha de auditoria do MYRMEX, cada evento abre com campos nomeados: data e hora, origem, tipo, usuário, agente, ferramenta, alvo, comando, status, duração, sessão e invocação, mais o payload da chamada. O comando efetivo aparece por extenso, do jeito que rodou.
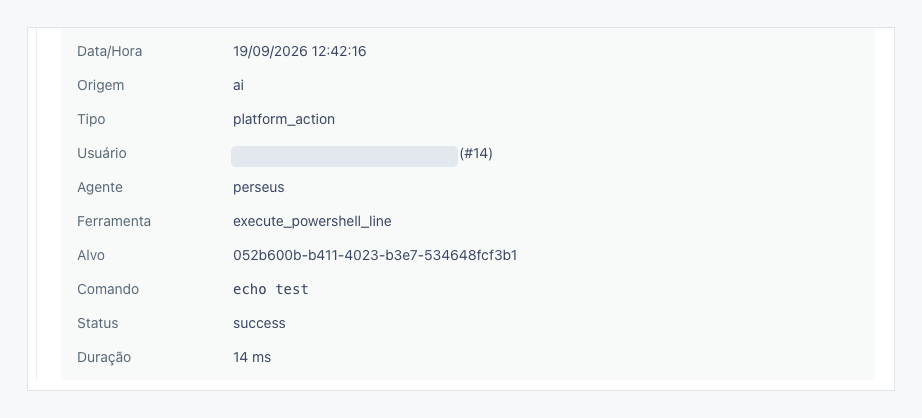
Dois desses campos fazem quase todo o trabalho.
O primeiro é a separação entre usuário e agente. São dois campos distintos, e a origem do evento é registrada à parte. Sem isso, uma revisão de acesso não consegue responder a pergunta mais básica do ano: dessas ações, quantas foram de gente? À medida que agentes passam a ter identidade e permissão próprias, um registro que trata os dois como "usuário" perde a capacidade de responder isso justamente quando ela passa a ser cobrada.
O segundo é o comando efetivo. É a diferença entre saber que alguém aprovou uma remediação e saber o que a remediação fez. Sem ele, o registro descreve uma decisão. Com ele, o registro reconstrói um fato.
Isso também explica por que o registro precisa nascer estruturado, campo a campo, em vez de virar texto corrido num log. Um artigo aceito na BCCA 2026, conferência do IEEE, mediu a diferença: consultas forenses estruturadas alcançaram precisão 1.0 em buscas por guardrail e por delegação, enquanto a busca textual não estruturada ficou em 0,013 e 0,077. São duas ordens de grandeza, e elas aparecem no pior momento possível, que é quando alguém precisa reconstruir o que aconteceu.
O que perguntar a qualquer fornecedor, inclusive a nós
Se você está avaliando plataformas com agentes que executam, estas cinco perguntas separam quem pensou no assunto de quem colocou um botão:
- O que vai para aprovação, o pedido ou o plano?
- O plano tem rollback escrito antes da execução, ou só depois que quebra?
- Onde fica registrada a autorização: numa tela de governança ou numa mensagem de chat?
- Quem executa verifica o resultado real, ou presume sucesso?
- O registro guarda o comando efetivo e separa ação humana de ação de agente?
Nenhuma delas é sobre autonomia, e é por isso que funcionam. Autonomia é uma régua ruim: todo fornecedor se posiciona onde for mais conveniente na conversa. As cinco acima são verificáveis numa demonstração, em quinze minutos, e não dependem de acreditar em ninguém.
Onde nos posicionamos
Continuamos dizendo que você decide e o Myrmex executa. O que este post acrescenta é o que sustenta a primeira metade da frase: uma decisão precisa de um plano legível antes, de verificação real durante e de um registro reconstruível depois. Sem os três, "controle humano" é uma linha de marketing.
Escrevemos recentemente sobre por que recusamos os rótulos AI SOC e AIOps, e a razão é a mesma que aparece aqui: a operação acontece dentro da tecnologia do cliente, e é lá que a evidência precisa ser produzida.
Ler o post sobre ITOps e SecOps · Ver as funcionalidades · Ver os planos
Fontes citadas:
Sharon Shea, "AI agent security must move beyond human in the loop, experts say", TechTarget, 18/08/2026.
Bindschaedler, Botha e Siebenbrunner, "Agent Flight Recorder: Tamper-Evident Audit Trails with On-Chain Anchoring for Long-Horizon Tool-Using Agents", arXiv 2609.01931, aceito na BCCA 2026.